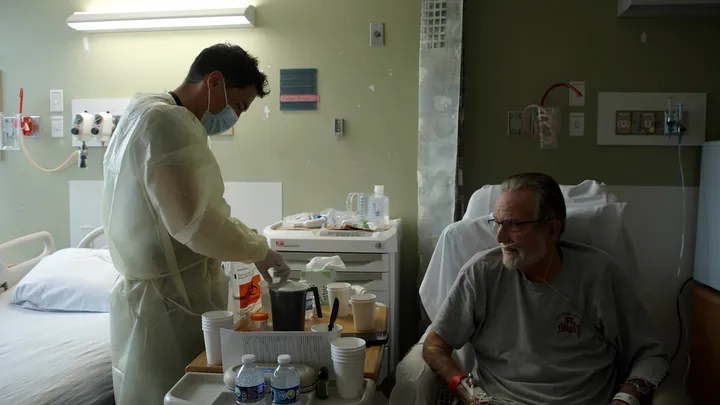
想象一下,你向医生描述自己的疼痛,而她的目光从你移向屏幕。屏幕上显示你是低风险。你的身体却在发出相反的信号。在两者之间,总得有人被相信。
全球各地的医院都在竞相把算法引入临床,从对病人进行分诊的症状检查器到辅助诊断的人工智能工具。其宣传点是提高效率、促进协调并提升准确性。
但这些系统在手册中很少提及的一点是:它们在悄然决定谁的知识是可信的、哪些症状重要以及病人的话应如何被诠释。
我将这种动态称为算法性煤气灯效应(algorithmic gaslighting)。
没有操作者的煤气灯效应
“医学上的煤气灯效应”指的是病人的症状被临床医生忽视或重新解释,这种情况常常沿着性别、种族或慢性病等脉络出现。
批评者认为这个词被滥用,因为煤气灯效应暗含故意欺骗,而大多数表现出轻视的医生并不是在策划阴谋。他们的行为往往源于隐性偏见、制度化惯例和根深蒂固的专业等级观念。
但伤害并非由动机来定义,而是由病人所遭遇的后果来定义:病人因此怀疑自己的感知,失去用语言表达体验的途径。
当算法介入时,这一点就无从回避。一段软件没有意图,它不能算计或欺骗。
然而,它可以以看似中立的权威来压倒病人的陈述,把活生生的叙述压缩进僵化的类别,并让病人觉得自己的体验不可靠。
这就是无操作者的煤气灯效应。
其一是数据暴力。医学数据集往往偏向白人、男性和社会经济地位较高的人群。那些不符合这种模式的病人在统计上变得“不可见”。
例如,胸痛在女性与男性的表现常有差异,但心血管数据中却过度编码了男性的病例。再如血氧饱和度仪多数在肤色较浅的人群上校准,可能会高估黑人病人的血氧值,从而掩盖危险的低氧水平。如果分诊工具把这些读数视为事实依据,错误就会一路传导下去。
其二是不透明性。你可以与医生讨论其推理过程,但你无法就一个其推导过程对你和常常连医生也看不到的评分进行争论。
以 Epic 的败血症模型为例:这是在数百家美国医院中使用的专有预警系统。外部研究发现它的表现远不及开发者声称的水平,只检出大约三分之一的败血症病例,同时产生频繁的误报。无论是临床医生还是病人,都看不到任何单个预警背后的逻辑。
其三是自动化权威。当算法“说不一样”的时候,病人会感到有压力去怀疑自己的叙述,而临床医生也会犹豫去否决一个表面上客观的建议。
这种权威有时会超越证据。内部文件后来显示,IBM 推出的 Watson for Oncology 被全球作为权威决策支持工具营销,但它给出的治疗建议曾不安全且不正确,而且其训练中大幅依赖假设性病例。
其四是反馈回路。病人和临床医生会学会哪些描述被视为可识别的“病例”,并据此调整他们的表达方式。这些调整后的描述又成为新的数据,固化了原先未能准确覆盖病人的那些类别。
久而久之,人们不再按自身体验去描述症状,而是按机器能“听懂”的方式去描述。
为什么这不是一个故障
把这一切当作可以通过更好的工程技术修复的漏洞很有诱惑力。但文章的论点并非如此。
算法并不会自发选择自己。医院和卫生系统选择采用它们,而出于效率、责任与规模等考虑,他们往往偏好标准化、基于病例的信息,而非混乱的人类叙述。
这是一种古老的行政本能。机构总是偏爱那些它们能够读取、计数和审计的事物,而非那些无法被系统识别的东西。对系统而言,难以识别的就是难以治理的。
因此,意图进入这张图景的节点是在上游。没有人需要刻意不相信某个病人,但选择以标准化数据代替病人的口述证词本身就是一种有意的设计行为,应有人对其负责。
因为算法产出具有基础设施性质,其造成的伤害也不会局限于一次糟糕的就诊。它会在多个病例中重复出现,并在交叉边缘群体(例如一位数据中代表性很薄的黑人残障女性)身上不断累积。
那些被反复误认的群体可能会对整个医疗体系产生不信任。
这一问题也具有全球维度。在一项近期针对土耳其的定性研究中,不同的语言模型在相同的临床案例上给出了显著不同的伦理建议,它们在文化敏感性和解释深度上存在差异,即便它们引用的是相同的原则。
被编码进系统的那些参照框并非中立,尤其对那些远离这些系统开发地的病人而言更是如此。
应当改变的方向
答案不是把人工智能从医疗中全面禁止,而是停止把病人仅视为数据来源,开始把他们当作有知识的人来看待。
首先,病人应有权对算法输出提出异议,而不仅仅是请求第二诊断。他们应能质询背后的类别、替代指标和价值判断,并获得能与自身体验相连的解释,而不是一份技术性的特征权重读数。
第二,认识论正义必须内建于系统之中。这包括对训练数据和输出进行独立审计,并让伦理学家与病人维权者参与其中。设计阶段应把最有可能被误认的人群事先纳入,而不是在架构固定后再让他们加入。采购时也应问:一个工具是鼓励病人叙述,还是把叙述简化成打钩的选项?
参与式设计并非万能。论文对此持诚实态度:专有厂商会抵制外部审查,私有化系统背后没有单一资助方,急诊护理也很难进行共同设计。参与式设计在慢性护理场景和已有病人组织的领域效果最好。不能全面实施时,设立较轻的保障总比没有强。
第三,责任需要被分担。开发者应记录系统的限制并为可争议性进行设计。临床医生应把算法输出与病人提供的信息一并权衡。机构应建立监督部署并解决争议的机构。监管者应把认识论正义写入护理标准。
有必要作一项说明:我的论点属于概念性和伦理性的讨论,并不声称衡量这些伤害发生的频率,实证研究将是必要的。但一个连名称都无法给出的问 题,是无法被研究的。
问题不再是医疗是否会被数字化介导——这肯定会发生。
问题在于,这种介导会拓宽还是狭窄病人被倾听的空间。一个无法相信面前这个人的卫生体系,就不再是一个真正的卫生体系。医学以信任为运行基础,无论多么准确的模型,都无法替代病人的声音。